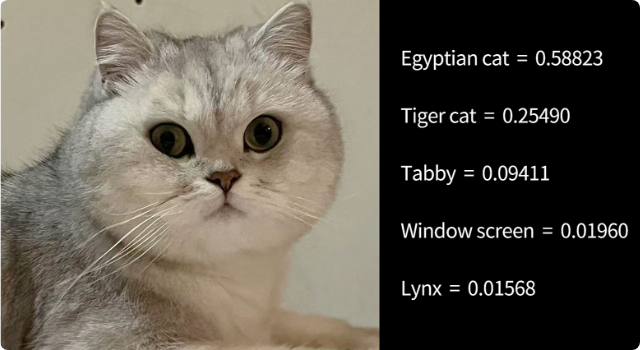
EfficientNet-B0是Google在2019年提出的EfficientNet系列的基础版本。EfficientNet通过一种称为“复合缩放”(Compound Scaling)的方法,联合优化了网络的深度、宽度和分辨率,从而实现了更高的计算效率和精度。EfficientNet-B0使用了Mobile Inverted Bottleneck卷积(MBConv)模块,并结合了深度可分离卷积,从而显著减少了参数和计算量。尽管是系列中的最小模型,EfficientNet-B0在多个计算机视觉任务中表现出色,能够在保持高精度的同时实现较低的资源需求,广泛应用于移动设备和边缘计算等资源受限的环境。
源模型
- 输入尺寸: 224x224
- 参数量: 5.04M
- 模型大小: 20.16M
- 输出尺寸:1x1000
源模型仓库:EfficientNet-B0
Model Farm 提供预编译好的模型资源以及推理代码,支持以下两种方式获取:
通过 Model Farm 页面获取:在右侧性能参考板块中点击模型 & 代码获取模型资源及代码包。
通过命令获取(推荐):持有阿加犀开发板的用户,可以通过开发板内置的 MMS 工具获取模型资源及代码包。
# 模型查询
mms list [model name]

# 模型资源获取
mms get -m [model name] -p [precision] -c [soc] -b [backend] -d [file path]
MMS 具体使用请参考:MMS 使用 & 提前获取预览版块模型
当用户对源模型进行过微调,需要重新进行模型转换。
用户可以自行参考以下两种方式完成模型转换:
使用 AIMO 完成模型转换:在右侧性能参考板块中点击模型转换参考查看模型转换步骤
使用高通 QNN 完成模型转换:请参考 Qualcomm QNN 文档
Model Farm 所提供的模型性能基准测试以及示例代码皆基于阿加犀AidLite SDK 实现。
对于模型文件格式为 .bin 的模型,可以使用以下两种推理引擎完成模型在高通芯片上推理:
使用 APLUX AidLite 推理:详情请参考 APLUX AidLite 开发者文档
使用 Qualcomm QNN 推理:请参考 Qualcomm QNN 文档
推理示例代码
推理示例代码是基于 AidLite SDK 实现
点击模型 & 代码下载模型文件和推理代码包,文件结构如下
/{model_name}_{SoC Name}_{Precision}

    |__ models # folder where model files are stored

    |__ code # aidlite python model inference example

        |__ python # aidlite python model inference example

        |__ cpp # aidlite cpp model inference example

        |__ README.md